


















































이 글은 데이터베이스 기초 개념을 처음 공부하는 사람을 위해 정리한 글이다. 쇼핑몰에서 주문한 상품을 다음 날 다시 확인하거나, 앱을 껐다 켜도 내가 작성한 글이 그대로 남아 있는 것은 익숙한 일이다. 화면에는 몇 줄의 정보만 보이지만, 그 뒤에서는 데이터를 저장하고 필요한 순간에 꺼내 오는 과정이 이루어진다. 이때 중심이 되는 것이 바로 데이터베이스(Database, DB)다.
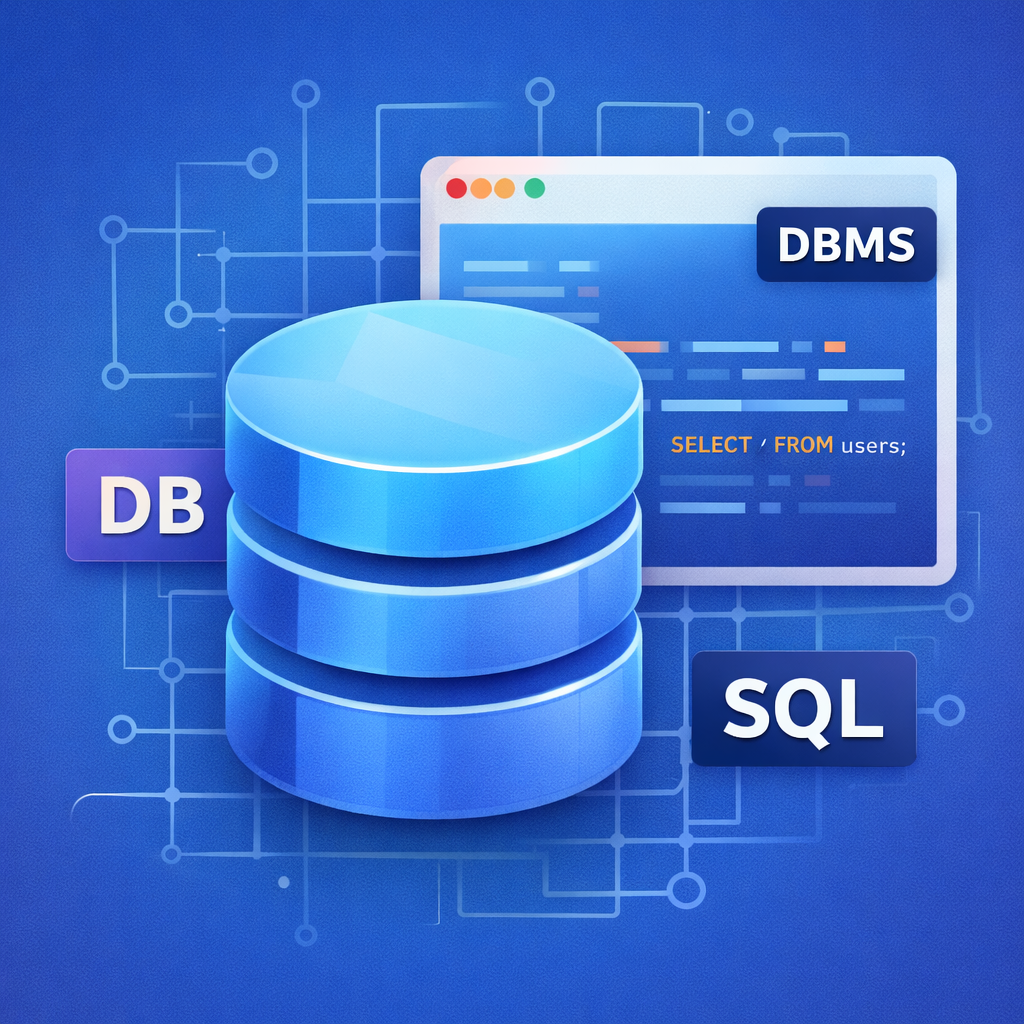
데이터베이스(DB)란 무엇인가를 이해하려면 용어의 뜻만 외우기보다, 데이터가 어떻게 저장되고 서로 연결되는지 살펴보는 편이 좋다. 이번 글에서는 작은 쇼핑몰을 예로 들어 DB와 DBMS의 차이, SQL의 역할, 관계형 데이터베이스와 NoSQL까지 순서대로 정리해 보겠다.
데이터베이스(DB)란 무엇인가? 파일만으로는 부족한 이유
데이터베이스는 필요한 정보를 저장하고 조회할 수 있도록 체계적으로 구성한 데이터의 집합이다. 회원 정보, 상품 목록, 주문 기록, 게시글처럼 서비스가 계속 기억해야 하는 정보가 여기에 해당한다.
처음에는 주문 내역을 엑셀이나 텍스트 파일에 적어도 큰 문제가 없을 수 있다. 하지만 주문이 늘어나고 여러 직원이 같은 내용을 수정하기 시작하면 이야기가 달라진다. 어느 파일이 최신인지 확인해야 하고, 같은 회원의 주소를 여러 곳에 중복해서 적었다면 일부만 수정되는 일도 생긴다.
따라서 서비스에서는 단순히 데이터를 보관하는 것뿐 아니라 여러 요청을 함께 처리하고, 데이터의 규칙을 지키며, 필요한 정보만 찾아내는 기능이 필요하다. 데이터베이스와 이를 관리하는 소프트웨어를 함께 사용하는 이유가 여기에 있다. 엑셀이 쓸모없다는 뜻은 아니다. 개인의 분석이나 작은 목록 관리에는 편리하지만, 여러 사용자가 이용하는 서비스의 저장소와는 요구사항이 다르다.
SQL 문법을 더 자세히 보고 싶다면 SQL 기본 정리 글을 함께 보자. 대표적인 DBMS인 MySQL의 특징은 MySQL 공식 문서에도 잘 정리되어 있다.
데이터베이스 기초 용어: DB, DBMS, SQL의 차이
데이터베이스를 공부하다 보면 DB, DBMS, SQL을 비슷한 뜻으로 사용하는 것처럼 느껴질 수 있다. 실제 대화에서는 줄여 부르기도 하지만, 세 가지의 역할은 구분해 두는 것이 좋다.
| 구분 | 의미 | 쇼핑몰에서의 예 |
|---|---|---|
| DB | 체계적으로 저장된 데이터의 집합 | 회원·상품·주문 데이터 |
| DBMS | DB를 생성하고 관리하는 소프트웨어 | PostgreSQL, MySQL 등 |
| SQL | 관계형 DB에서 데이터를 정의하고 다루는 언어 | 특정 회원의 주문 조회 |
DBMS(Database Management System)는 데이터베이스 관리 시스템을 의미한다. 데이터를 저장하고 검색하는 기능 외에도 접근 권한, 동시 처리, 데이터 무결성, 장애 복구 등을 지원한다. 대표적인 관계형 DBMS로는 MySQL, PostgreSQL, Oracle Database, Microsoft SQL Server가 있다.
SQL(Structured Query Language)은 이러한 관계형 DBMS에 원하는 작업을 전달하는 표준 언어다. 다만 제품마다 지원하는 기능과 세부 문법에는 차이가 있다. DB가 데이터 자체라면, DBMS는 이를 관리하는 프로그램이고, SQL은 프로그램에 요청을 전달하는 언어라고 이해하면 된다.
관계형 데이터베이스: 테이블과 키로 연결하기
관계형 데이터베이스는 데이터를 행과 열로 이루어진 테이블에 저장한다. 열(Column)은 회원 번호나 이름 같은 항목이고, 행(Row)은 회원 한 명처럼 실제 데이터 한 건이다. 이러한 관계형 데이터베이스를 관리하는 시스템을 RDBMS(Relational Database Management System)라고 한다. 관계형 데이터베이스 자체와 관리 소프트웨어의 명칭을 구분하면 혼동을 줄일 수 있다.
예를 들어 회원과 주문을 다음과 같이 나누어 저장했다고 가정해 보자. 아래의 이름과 주문은 설명을 위한 가상 데이터다.
회원 테이블: users
| user_id | name |
|---|---|
| 1 | 민수 |
| 2 | 지연 |
주문 테이블: orders
| order_id | user_id | total_amount |
|---|---|---|
| 101 | 1 | 30000 |
| 102 | 1 | 15000 |
| 103 | 2 | 22000 |
회원 테이블의 user_id는 각 회원을 구분하는 기본 키(Primary Key)로 사용할 수 있다. 주문 테이블의 user_id에는 주문한 회원의 번호를 저장한다. 이 열을 회원 테이블의 기본 키를 참조하는 외래 키(Foreign Key)로 설정하면, 존재하지 않는 회원 번호가 주문에 들어가지 않도록 제약을 줄 수 있다.
이 구조에서는 민수가 주문을 두 번 하더라도 이름을 주문마다 반복해서 저장할 필요가 없다. 회원 정보와 주문 정보를 연결해 읽으면 되기 때문이다. 이렇게 데이터를 나누고 연결하는 방법이 데이터 모델링의 출발점이다. 테이블을 나누었다고 저절로 관계가 보장되는 것은 아니므로, 키와 제약 조건도 함께 설계해야 한다.
데이터베이스 기초 SQL: 원하는 주문을 조회해 보기
앞에서 본 회원 테이블이 이미 만들어져 있다면, 다음 SQL로 모든 회원을 조회할 수 있다.
SELECT * FROM users;SELECT는 조회할 열을 지정하고, FROM은 조회할 테이블을 지정한다. 여기서 *는 모든 열을 의미한다. 학습할 때는 편리하지만, 실제 서비스에서는 필요한 열을 명시하면 어떤 데이터를 사용하는지 더 분명하게 드러난다.
이번에는 주문 테이블에서 회원 번호가 1인 사람의 주문만 찾아보자.
SELECT order_id, total_amount
FROM orders
WHERE user_id = 1
ORDER BY order_id;WHERE는 조회 조건이고, ORDER BY는 결과를 정렬하는 기준이다. 위의 가상 데이터에서는 주문 번호 101과 102가 차례로 나오며, 주문 금액은 각각 30000과 15000이다. 모든 주문을 가져온 뒤 사람이 찾는 대신, 필요한 조건을 데이터베이스에 전달하는 것이다.
회원 이름까지 함께 보고 싶다면 두 테이블을 JOIN으로 연결할 수 있다.
SELECT u.name, o.order_id, o.total_amount
FROM users AS u
JOIN orders AS o ON u.user_id = o.user_id
WHERE u.user_id = 1
ORDER BY o.order_id;
이 쿼리는 두 테이블의 user_id가 같은 행을 연결한다. 결과에는 민수의 이름과 두 건의 주문이 함께 표시된다. u와 o는 테이블 이름을 짧게 부르기 위한 별칭이다. 처음에는 모든 문법을 외우기보다, 어느 테이블에서 어떤 조건으로 무엇을 가져오는지 읽는 연습부터 해보는 것이 좋다.
SQL은 조회만 하는 언어가 아니다. INSERT는 데이터 추가, UPDATE는 수정, DELETE는 삭제에 사용한다. 특히 수정과 삭제는 조건을 잘못 지정하면 여러 행에 영향을 줄 수 있으므로, 실습용 데이터베이스에서 대상 행을 먼저 조회해 확인하는 습관이 필요하다.
저장만큼 중요한 데이터의 정확성
주문이 접수되면 주문 기록을 추가하고 상품의 재고도 줄여야 한다. 그런데 주문만 저장되고 재고 변경은 실패한다면, 화면에 보이는 주문 내역과 실제 재고가 맞지 않을 수 있다. 이처럼 함께 처리해야 하는 작업을 하나의 단위로 묶는 개념이 트랜잭션(Transaction)이다.
트랜잭션 안의 작업은 모두 성공했을 때 확정하고, 문제가 생기면 취소하도록 구성할 수 있다. 다만 DBMS를 설치했다고 주문 처리 로직이 자동으로 안전해지는 것은 아니다. 개발자가 트랜잭션 범위와 동시 요청 처리 방식을 올바르게 설계해야 한다.
조회 속도 역시 데이터베이스를 사용한다고 무조건 빨라지는 것은 아니다. 데이터가 커지면 자주 사용하는 검색 조건에 맞는 인덱스(Index)가 도움이 될 수 있다. 반대로 인덱스는 저장 공간을 차지하고 데이터 변경 시 관리 비용도 발생한다. 처음에는 테이블과 SQL을 이해하고, 이후 실행 계획과 인덱스를 배우는 순서가 자연스럽다.
NoSQL 데이터베이스는 무엇이 다른가?
모든 데이터를 같은 테이블 구조로 다루는 것이 편리한 것은 아니다. 상품마다 속성의 종류가 크게 다르거나, 키 하나로 값을 빠르게 읽는 방식이 중심인 서비스도 있다. 이런 요구에 따라 문서형, 키-값형, 와이드 컬럼형, 그래프형 등 다양한 NoSQL 데이터베이스가 활용된다.
NoSQL은 흔히 “Not Only SQL”이라는 표현으로 설명된다. 단순히 SQL을 전혀 쓰지 못한다는 뜻으로 외우기보다, 전통적인 관계형 모델 외의 다양한 데이터 모델을 포괄하는 용어로 이해하는 편이 정확하다. 제품에 따라 쿼리 언어, 일관성 모델, 트랜잭션 지원 범위가 다르다.
| 예시 | 주요 데이터 모델 | 활용 예 |
|---|---|---|
| MongoDB | 문서형 | 중첩된 속성을 가진 문서 저장 |
| Redis | 키-값 및 다양한 자료구조 | 캐시, 세션 등 빠른 접근이 필요한 데이터 |
| Cassandra | 와이드 컬럼형 | 분산 환경의 대규모 쓰기 처리 |
따라서 “데이터가 많으면 무조건 NoSQL이 좋다”거나 “NoSQL에는 데이터 구조가 없다”고 판단해서는 안 된다. 구조를 유연하게 바꿀 수 있어도 데이터 형식과 검증 규칙은 필요하다. 관계형 DB도 대규모 서비스에서 사용되며, 실제 선택은 조회 방식, 데이터 관계, 일관성 요구, 운영 경험 등을 함께 고려해야 한다.
예를 들어 쇼핑몰의 회원과 주문은 관계형 DB에 저장하고, 자주 읽는 상품 조회 결과는 Redis에 잠시 보관하는 식으로 함께 사용할 수도 있다. 이때 캐시는 원본 데이터와 달라질 수 있으므로 만료와 갱신 규칙이 필요하다. 각 도구의 장점을 이해하는 것이 특정 제품 하나를 정답으로 정하는 것보다 중요하다.
정리: 데이터베이스 기초 공부는 작은 테이블부터
지금까지 데이터베이스의 개념에서 출발해 쇼핑몰의 회원과 주문을 연결하고, SQL로 필요한 정보를 조회하는 과정까지 살펴보았다. DB는 데이터의 집합, DBMS는 이를 관리하는 소프트웨어, SQL은 관계형 DB를 다루는 언어라는 차이를 먼저 기억해 두면 된다.
그다음에는 행과 열, 기본 키와 외래 키를 이해하고 SELECT → WHERE → JOIN 순서로 간단한 조회를 연습해 보자. “회원 번호 1의 주문은 몇 건인가?”, “각 주문을 한 회원의 이름은 무엇인가?”처럼 질문을 정하고 SQL로 답을 구하면 용어가 실제 동작으로 연결되기 시작한다.
결국 데이터베이스를 배운다는 것은 정보를 많이 넣는 방법만 배우는 일이 아니다. 어떤 데이터를 저장하고, 어떤 규칙으로 연결하며, 필요한 순간에 정확하게 꺼낼지 설계하는 과정이다. 이 기초를 이해하면 이후에 배우게 될 데이터 모델링, 인덱스, 서버 개발도 훨씬 쉽게 따라갈 수 있다.
조건을 더 다양하게 사용해 보고 싶다면 SQL WHERE 조건 정리를 이어서 읽어보자. 조회가 느려지는 이유가 궁금하다면 인덱스란 무엇인가에서 다음 단계의 개념을 살펴볼 수 있다.
참고 자료
직접 실습하며 더 살펴보고 싶다면 PostgreSQL 공식 SQL 입문 문서에서 테이블과 조회, JOIN 예제를 확인할 수 있다. 문서형 데이터 모델은 MongoDB 공식 매뉴얼을 함께 참고하면 좋다.












첫 댓글을 남겨보세요