


들어가며: 인덱스는 만드는 것보다 설계가 어렵다
인덱스 설계 작업이 생각보다 어렵다는 걸 체감하는 순간은 보통 이렇다. 느린 쿼리를 발견하고 SQL 실행 계획(EXPLAIN) 보는 방법 글에서 다룬 것처럼 실행 계획을 확인한다. type이 ALL이고 key가 NULL이다. 그래서 WHERE 절의 컬럼에 인덱스를 하나 만든다. 그런데 어떤 쿼리는 빨라지고, 어떤 쿼리는 그대로이며, 심지어 인덱스를 만들었는데도 옵티마이저가 쳐다보지도 않는 경우가 생긴다.
인덱스를 “만드는 방법”은 한 줄이면 끝나지만, “어떤 컬럼을 어떤 순서로 묶을지”는 쿼리 패턴을 이해해야 정할 수 있다. 인덱스의 기본 개념은 인덱스란 무엇인가 글에서 다뤘으니, 이번 글에서는 한 단계 더 들어가 MySQL(InnoDB) 기준으로 인덱스 설계 원칙을 정리해 보려고 한다. 예제는 EXPLAIN 글에서 사용한 100만 건짜리 orders 테이블을 그대로 이어서 쓴다.
인덱스 설계 전에 알아야 할 두 가지: 카디널리티와 선택도
카디널리티(Cardinality)는 컬럼에 들어 있는 서로 다른 값의 개수다. orders 테이블로 보면 user_id는 1만 가지 값이 있고, status는 pending, completed, cancelled 세 가지뿐이다. 선택도(Selectivity)는 이를 전체 행 수로 나눈 비율로, 값 하나로 조회했을 때 얼마나 적은 행만 남는지를 나타낸다.
직접 확인하는 방법은 간단하다.
SELECT COUNT(DISTINCT user_id) AS user_cardinality,
       COUNT(DISTINCT status)  AS status_cardinality,
       COUNT(*)                AS total_rows
FROM orders;
-- user_cardinality: 10000, status_cardinality: 3, total_rows: 1000000user_id = 1234로 찾으면 100만 건 중 약 100건만 남는다. 반면 status = 'pending'은 약 33만 건이 남는다. 이렇게 많이 남는 조건이라면 옵티마이저는 인덱스를 거쳐 33만 번 왔다 갔다 하느니 테이블을 통째로 읽는 쪽을 택한다. EXPLAIN 글에서 “인덱스를 만들었는데 Full Scan을 한다”고 했던 경우가 바로 이것이다.
다만 카디널리티가 낮다고 무조건 인덱스에서 빼라는 뜻은 아니다. 단독으로는 쓸모가 없어도 복합 인덱스 안에서 다른 조건과 함께 쓰이면 충분히 의미가 있다. 그래서 인덱스 설계의 핵심은 결국 복합 인덱스의 컬럼 순서로 이어진다.
복합 인덱스 컬럼 순서: 인덱스 설계 핵심 원칙
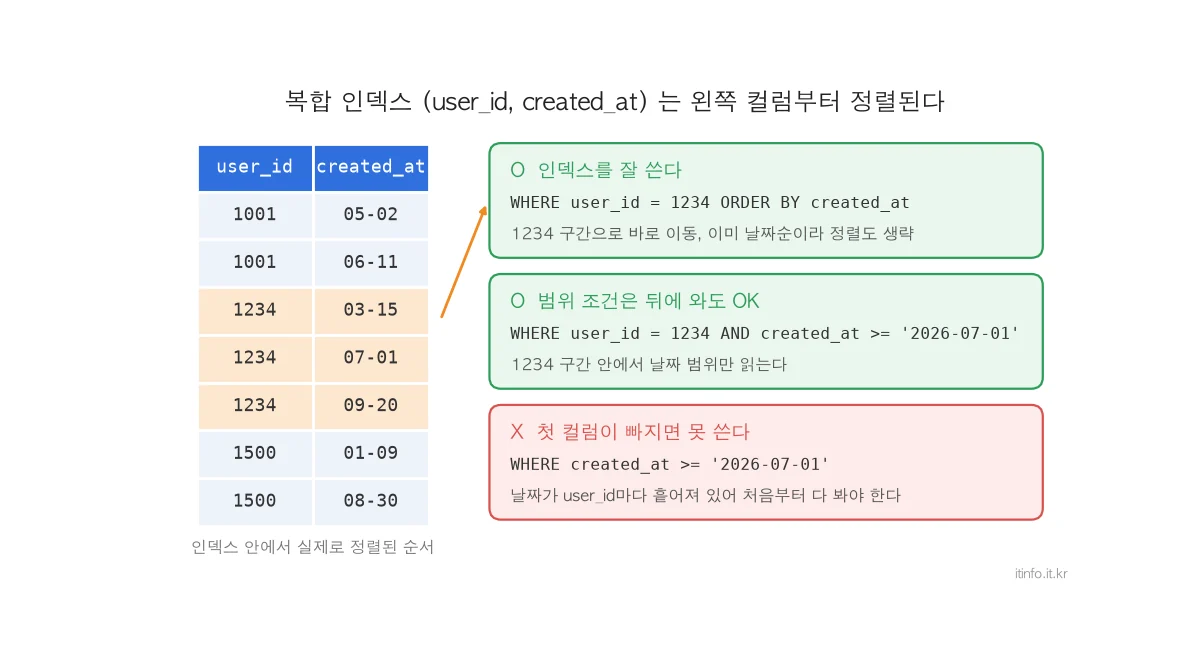
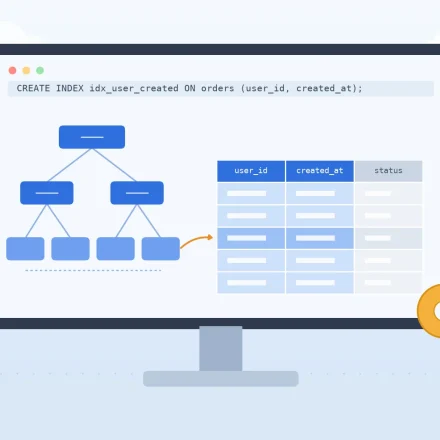
복합 인덱스는 여러 컬럼을 하나로 묶은 인덱스다. 중요한 건 정렬이 왼쪽 컬럼부터 차례로 된다는 점이다. 전화번호부가 성으로 먼저 정렬되고, 같은 성 안에서 이름으로 정렬되는 것과 같다.
원칙 1: 왼쪽 컬럼부터 써야 한다
(user_id, created_at) 인덱스는 user_id 조건이 있을 때 제 역할을 한다. created_at만으로 조회하면 날짜가 user_id마다 흩어져 있기 때문에 인덱스로 범위를 좁힐 수 없다. 전화번호부에서 성은 모르고 이름만으로 사람을 찾는 것과 같다.
CREATE INDEX idx_user_created ON orders (user_id, created_at);

-- 인덱스 사용 O
EXPLAIN SELECT * FROM orders WHERE user_id = 1234;
EXPLAIN SELECT * FROM orders WHERE user_id = 1234 AND created_at >= '2026-07-01';

-- 인덱스로 범위를 좁히지 못함
EXPLAIN SELECT * FROM orders WHERE created_at >= '2026-07-01';참고로 MySQL 8.0.13부터는 첫 컬럼의 값 종류가 아주 적을 때 Skip Scan으로 이런 쿼리에도 인덱스를 쓰는 경우가 있다. 다만 옵티마이저가 상황을 보고 판단하는 예외라서, 설계할 때는 “왼쪽부터”를 기본 원칙으로 두는 게 안전하다. 자세한 동작은 MySQL 공식 문서(Multiple-Column Indexes)를 참고하자.
원칙 2: = 조건 컬럼은 앞에, 범위 조건 컬럼은 뒤에
필자가 실무에서 가장 많이 본 실수가 이것이다. 같은 두 컬럼이라도 순서에 따라 성능이 크게 달라진다.
-- 쿼리: 특정 사용자의 최근 주문
SELECT * FROM orders
WHERE user_id = 1234
  AND created_at >= '2026-07-01';

-- 좋은 순서: = 조건(user_id) → 범위 조건(created_at)
CREATE INDEX idx_user_created ON orders (user_id, created_at);
-- 1234 구간으로 바로 이동한 뒤, 그 안에서 날짜 범위만 읽는다

-- 나쁜 순서: 범위 조건이 앞
CREATE INDEX idx_created_user ON orders (created_at, user_id);
-- 7월 이후 모든 사용자의 주문을 훑으면서 user_id를 하나씩 걸러 낸다범위 조건(>=, BETWEEN, LIKE 'abc%')이 걸린 컬럼 뒤에 오는 컬럼은 인덱스 탐색 범위를 좁히는 데 쓰이지 않는다. 실행 계획의 key_len을 보면 인덱스의 몇 번째 컬럼까지 쓰였는지 확인할 수 있으니, 순서를 바꿔 가며 직접 비교해 보는 것도 좋은 공부가 된다.
원칙 3: ORDER BY까지 인덱스 순서에 맞춘다
EXPLAIN 글의 패턴 2(Using filesort)에서 본 것처럼, 정렬 컬럼까지 인덱스에 포함하면 MySQL이 따로 정렬할 필요가 없다. 인덱스가 이미 정렬된 상태이기 때문이다.
-- user_id로 찾고 created_at으로 정렬 → (user_id, created_at) 인덱스 하나로 해결
EXPLAIN SELECT * FROM orders
WHERE user_id = 1234
ORDER BY created_at DESC
LIMIT 20;
-- Extra에 Using filesort가 나오지 않는다= 조건 컬럼 다음에 정렬 컬럼이 오도록 묶으면 “찾기”와 “정렬”을 인덱스 하나로 끝낼 수 있다. 게시판 목록이나 주문 내역처럼 최신순으로 잘라서 보여 주는 화면에서 특히 효과가 크다.
자주 하는 오해: 카디널리티 높은 컬럼을 무조건 앞에?
“카디널리티가 높은 컬럼을 앞에 두라”는 말을 많이 듣는다. 둘 다 = 조건이라면 대체로 맞는 말이다. 하지만 그보다 우선하는 건 쿼리 패턴이다. 항상 조건에 들어가는 컬럼, 그리고 = 조건으로 쓰이는 컬럼이 앞에 와야 한다. 카디널리티가 아무리 높아도 범위 조건으로만 쓰이는 컬럼을 맨 앞에 두면 원칙 2에서 본 문제가 그대로 생긴다.
커버링 인덱스: 테이블을 아예 안 읽게 만드는 인덱스 설계
인덱스로 행을 찾았다고 끝이 아니다. SELECT *처럼 인덱스에 없는 컬럼이 필요하면, 찾은 행마다 실제 테이블로 다시 가서 나머지 컬럼을 읽어 와야 한다. 반대로 쿼리에 필요한 컬럼이 모두 인덱스 안에 있으면 테이블은 건드리지도 않는다. 이것을 커버링 인덱스라고 한다.
-- 인덱스에 없는 컬럼(status, amount)까지 필요 → 테이블 접근 발생
EXPLAIN SELECT * FROM orders WHERE user_id = 1234;

-- 필요한 컬럼이 모두 인덱스 안에 있음 → Extra: Using index
EXPLAIN SELECT user_id, created_at FROM orders WHERE user_id = 1234;

-- InnoDB의 보조 인덱스에는 PK(id)가 자동으로 함께 들어 있어서 이것도 커버링
EXPLAIN SELECT id, created_at FROM orders WHERE user_id = 1234;실행 계획의 Extra에 Using index가 보이면 커버링 인덱스로 처리됐다는 뜻이다. 그래서 목록 화면처럼 자주 실행되는 쿼리라면 습관처럼 SELECT *를 쓰기보다 정말 필요한 컬럼만 가져오는 것이 좋다. 그것만으로도 인덱스 설계의 효과가 훨씬 커진다.
인덱스 설계 시 주의할 점: 많을수록 좋을까?
그렇지 않다. 인덱스 설계 과정에서 가장 쉽게 놓치는 부분이 바로 비용이다. 인덱스는 조회를 빠르게 하는 대신 대가를 치른다.
- 쓰기 성능 저하 : INSERT·UPDATE·DELETE마다 모든 인덱스를 함께 수정해야 한다. 인덱스가 10개면 한 번 쓸 때 10곳을 고친다.
- 저장 공간 : 인덱스도 디스크와 메모리(버퍼 풀)를 차지한다.
- 옵티마이저 혼란 : 비슷한 인덱스가 여러 개면 기대와 다른 인덱스를 고르기도 한다.
특히 흔한 게 중복 인덱스다. EXPLAIN 글의 실습을 그대로 따라 했다면 지금 orders 테이블에는 idx_user_id (user_id)와 idx_user_created (user_id, created_at)가 둘 다 있을 것이다. 그런데 뒤의 인덱스가 앞부분에 user_id를 이미 갖고 있으므로, idx_user_id로 할 수 있는 일은 idx_user_created로 모두 할 수 있다. 즉 앞의 인덱스는 지워도 된다.
MySQL 8.0의 sys 스키마를 쓰면 중복 인덱스와 쓰이지 않는 인덱스를 쉽게 찾을 수 있다.
-- 다른 인덱스와 겹치는(중복) 인덱스
SELECT table_name, redundant_index_name, dominant_index_name
FROM sys.schema_redundant_indexes
WHERE table_schema = DATABASE();

-- 서버가 켜진 이후 한 번도 쓰이지 않은 인덱스
SELECT object_name, index_name
FROM sys.schema_unused_indexes
WHERE object_schema = DATABASE();

-- 중복 인덱스 정리
DROP INDEX idx_user_id ON orders;단, “쓰이지 않은 인덱스”는 서버가 재시작된 뒤부터 집계되므로 월말 정산처럼 가끔만 도는 쿼리가 쓰는 인덱스일 수도 있다. 바로 지우기보다 충분한 기간을 두고 확인한 뒤 정리하자. 자세한 내용은 MySQL sys 스키마 문서에 나와 있다.
인덱스 설계 체크리스트
지금까지 내용을 실무에서 바로 쓸 수 있게 정리하면 다음과 같다.
| 점검 항목 | 확인할 것 |
|---|---|
| 자주 쓰는 쿼리 | WHERE·ORDER BY·GROUP BY에 실제로 어떤 컬럼이 오는가 |
| 컬럼 순서 | = 조건 컬럼이 앞, 범위 조건 컬럼이 뒤에 있는가 |
| 정렬 | ORDER BY 컬럼까지 인덱스 순서에 포함되어 있는가 |
| 커버링 | 자주 조회하는 컬럼만으로 인덱스가 끝나는가 (Using index) |
| 중복 | 다른 인덱스의 앞부분과 겹치는 인덱스는 없는가 |
| 검증 | EXPLAIN으로 type·key·rows·Extra를 다시 확인했는가 |
나오며: 인덱스 설계 출발점은 쿼리다
인덱스 설계는 테이블을 보고 하는 게 아니라 쿼리를 보고 하는 일이다. 어떤 조건으로 찾고, 어떤 순서로 정렬하고, 어떤 컬럼을 가져가는지가 정해져야 비로소 어떤 인덱스가 필요한지 보인다. 그리고 만든 뒤에는 반드시 실행 계획으로 확인한다.
이것으로 인덱스란 무엇인가(개념) → SQL 실행 계획(EXPLAIN) 보는 방법(진단) → 인덱스 설계(처방)로 이어지는 흐름을 한 번 정리했다. 느린 쿼리를 만나면 이 순서대로 다시 짚어 보자. 감으로 인덱스를 추가하던 때보다 훨씬 빠르게 원인에 닿을 수 있을 것이다.


첫 댓글을 남겨보세요